
Ende September durfte ich beim Vortrag „Microsoft KI-Agenten und ihre Interaktion mit unterschiedlichen Modellen“ zeigen, warum die Frage nach dem richtigen KI-Modell im Microsoft Copilot längst keine Geschmacksfrage mehr ist. In diesem Beitrag fasse ich die wichtigsten Erkenntnisse zusammen – und ergänze sie um einen Punkt, der für Unternehmen in Deutschland und der EU mindestens genauso wichtig ist wie Qualität und Kosten: Wo werden meine Daten eigentlich verarbeitet?
Wie die meisten KI-Projekte beginnen
Sie kennen das Meme vielleicht: „Was wollen wir?“ – „KI!“ – „KI wofür?“ – „Wissen wir nicht!“ – „Wann wollen wir sie?“ – „Sofort!“. Genau so starten leider viele KI-Initiativen. Man kauft eine Lizenz, rollt den Copilot aus – und bearbeitet dann jede Aufgabe mit demselben Modell und denselben Einstellungen.
Meine These aus dem Vortrag lautet deshalb bewusst zugespitzt:
Wer heute einfach zwischen zwei KIs wechseln kann, nutzt sie nicht richtig.
Denn GPT und Claude sind nicht austauschbar. Sie haben unterschiedliche Stärken, verbrauchen unterschiedlich viele Credits und – das wird oft übersehen – sie unterliegen in der EU unterschiedlichen Datenschutz-Rahmenbedingungen.
Welche KI-Modelle stehen im Copilot zur Auswahl?
Im Microsoft Copilot gibt es inzwischen zwei Modellfamilien: OpenAI (GPT) und Anthropic (Claude). Dazu kommt der Modus Auto, der standardmäßig aktiv ist und je Aufgabe aus den freigegebenen Modellen auswählt.
- Auto (Standard): wählt je Aufgabe automatisch aus den freigegebenen Modellen
- GPT 5.5: als „Schnelle Antwort“ und als „Deep Thinking“ für tiefere Analysen
- GPT 5.6: als zusätzliche Auswahl
- Claude Sonnet 5 und Claude Opus 5
- In einigen Apps zusätzlich noch Claude Sonnet 4.8 und Opus 4.8
Stärken und Schwächen: GPT vs. Claude
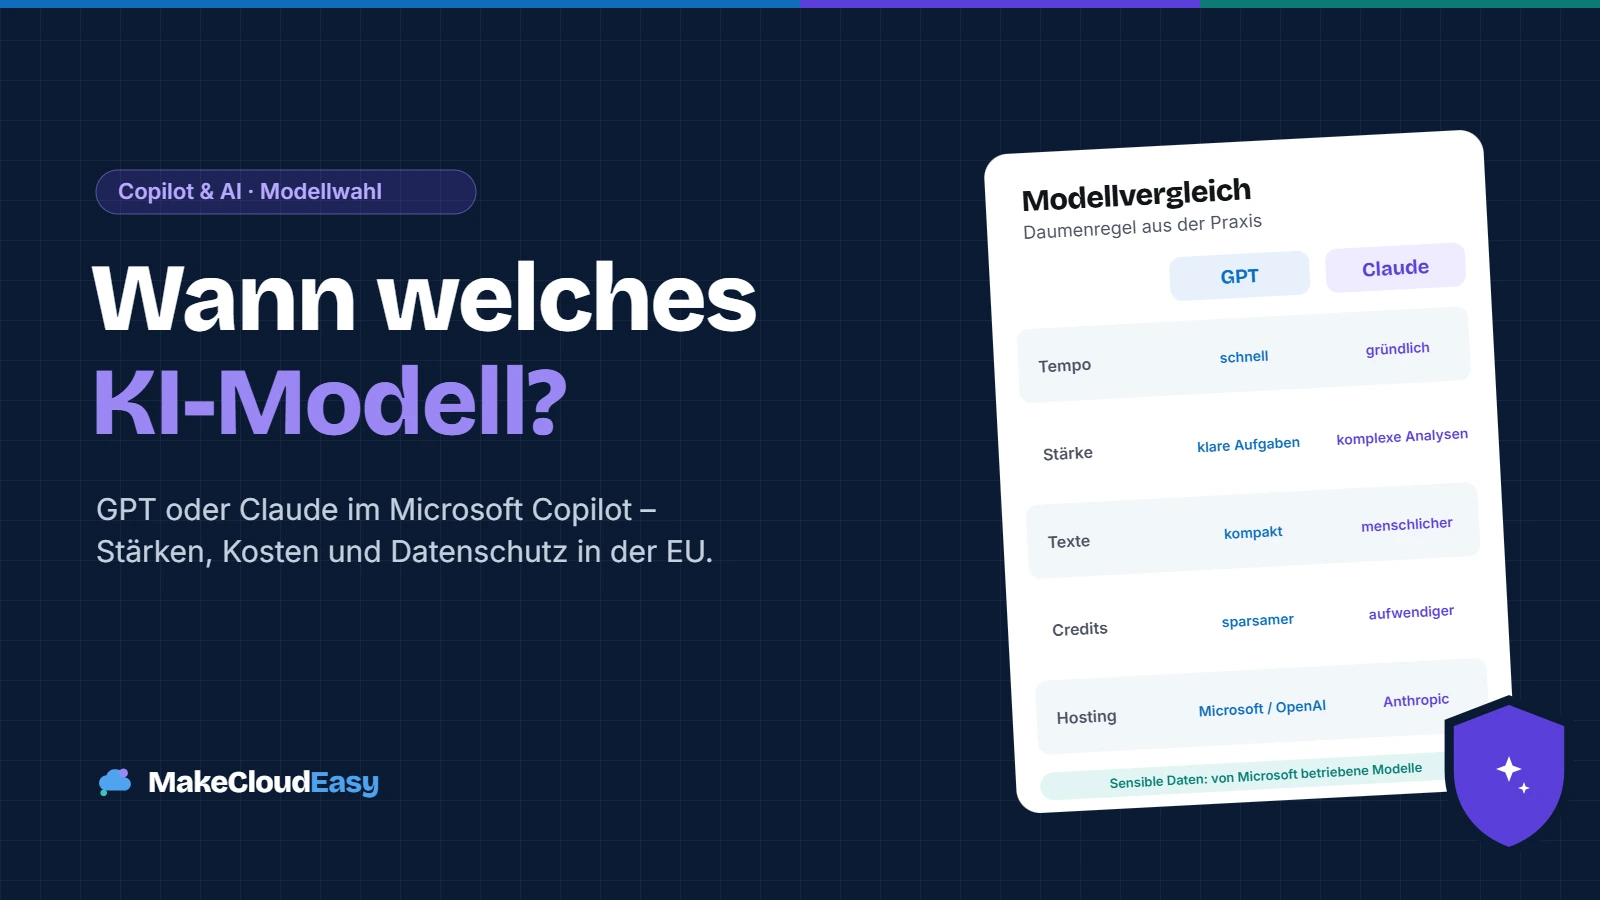
Aus meiner Praxis lassen sich die beiden Modellfamilien trotzdem recht klar charakterisieren:
- Claude arbeitet gründlicher, prüft Ergebnisse mehrfach und reduziert dadurch Halluzinationen. Dafür benötigt es deutlich mehr Zeit und Ressourcen. Der Schreibstil wirkt zudem menschlicher.
- GPT liefert schneller Ergebnisse und beantwortet viele Fragen korrekt, neigt bei Wissenslücken jedoch häufiger zu Spekulationen.
Meine Einsatzempfehlung: GPT für schnelle, klar definierte Aufgaben – Claude Opus für komplexe Analysen und hochwertige Textarbeit.
Welches KI-Modell für welche Aufgabe in Copilot Cowork?
Außerdem ist die Modellauswahl in Copilot Cowork noch breiter. Die folgende Matrix nutze ich als Daumenregel – inklusive des passenden Reasoning-Efforts:
| Aufgabe | GPT | Claude | Effort | Warum |
|---|---|---|---|---|
| Schnelle Entwürfe, Lookups | GPT 5.6 Terra | Claude Sonnet 5 | Light–Medium | Minimale Latenz und Credits |
| Standardanalysen, Recaps | GPT 5.5 (Frontier) | Claude Sonnet 5 | Medium | Hosting in Azure AI Foundry, solide |
| Dokument-Pipelines, Analysen | GPT 5.6 Sol | Claude Opus 5 | High | Tiefe plus Selbstprüfung |
| Autonome Tasks, Browser, Apps | GPT 6 Astra | Claude Opus 5 | High | Computer Use, Artefakte |
| Härteste Reasoning-Probleme | GPT 6 Astra | Claude Fable 5.1 | Extra High–Max | Fable: Tiefe; Astra: Tokens |
| Sensible Daten | GPT 5.5 (Foundry) | – | – | Von Microsoft betrieben, ohne Speicherung beim Modellanbieter |
Der Modellkatalog und das Hosting
Spätestens hier wird es für Datenschutz und IT-Sicherheit spannend. Denn nicht jedes Modell wird von Microsoft selbst betrieben:
| Modell | Einsatzzweck | Hosting |
|---|---|---|
| Auto (Standard) | Wählt je Aufgabe aus den freigegebenen Modellen | abhängig vom gewählten Modell |
| GPT 5.5 (Frontier) | Leistungsfähig für Arbeit mit mittlerem Aufwand | Azure AI Foundry (von Microsoft betrieben) |
| GPT 5.6 Sol | Intelligent und effizient für harte Arbeit | OpenAI als Subprozessor |
| GPT 5.6 Terra | Ausgewogener Aufwand für Alltagsaufgaben | OpenAI als Subprozessor |
| GPT 6 Astra | Neuestes Modell für schwierige Probleme | OpenAI als Subprozessor |
| Claude Sonnet 5 | Alltag und schnelle Antworten | Anthropic als Subprozessor |
| Claude Opus 5 | Komplexe Arbeit mit hohem Anspruch | Anthropic als Subprozessor |
| Claude Fable 5.1 | Fortschrittlichstes Modell für ambitionierte Arbeit | Anthropic – Bedingungen je nach Berechtigung des Tenants prüfen |
Gut zu wissen: Fable 5.1 hat im September 2026 das bisherige Preview-Modell Fable 5 abgelöst.
Verfügbarkeit in Deutschland und der EU: Was Sie zum Datenschutz wissen müssen
Für Unternehmen im DACH-Raum ist das allerdings der vielleicht wichtigste Abschnitt. Die Modelle unterscheiden sich nicht nur in Qualität und Preis, sondern auch darin, wer die Daten verarbeitet und ob die Verarbeitung innerhalb der EU Data Boundary (EUDB) von Microsoft stattfindet.
1. Von Microsoft betriebene GPT-Modelle (Azure OpenAI / Foundry)
Zunächst die gute Nachricht: Die von Microsoft betriebenen OpenAI-Modelle sind die sicherste Wahl für sensible Daten. Sie laufen auf Microsofts eigener Infrastruktur, unterliegen vollständig den Microsoft Product Terms und dem Data Protection Addendum (DPA) und bleiben im Copilot unabhängig von den Subprozessor-Einstellungen verfügbar. Prompts, Antworten und Daten aus Microsoft Graph werden laut Microsoft nicht zum Training der Foundation-Modelle verwendet.
2. GPT-Modelle mit OpenAI als Subprozessor
Seit Juli 2026 stellt Microsoft zusätzlich Modelle bereit, die von OpenAI selbst betrieben werden – etwa GPT 5.6 Sol, GPT 5.6 Terra oder GPT 6 Astra. Die wichtigsten Punkte:
- OpenAI wurde am 23. Juni 2026 in die Liste der Microsoft-Subprozessoren aufgenommen und ist seit dem 9. Juli 2026 nutzbar.
- Seit dem 24. Juli 2026 sind diese Modelle für berechtigte kommerzielle Kunden standardmäßig für alle Benutzer aktiviert – sofern der Admin sie nicht aktiv deaktiviert.
- Es gelten die Microsoft Product Terms und das DPA; die Nutzung fällt unter Enterprise Data Protection.
- Die von OpenAI betriebenen Modelle sind in der EU Data Boundary enthalten (mit den in der EUDB-Dokumentation genannten Ausnahmen), aber aktuell von Zusagen zur In-Country-Verarbeitung ausgenommen.
- OpenAI verwaltet die Zertifizierungen für diese Modelle selbst – das sollte in Ihre Compliance-Prüfung einfließen.
3. Claude-Modelle mit Anthropic als Subprozessor
Bei Claude ist die Lage für europäische Kunden deutlich anders:
- Anthropic ist ebenfalls Microsoft-Subprozessor; Product Terms, DPA und Enterprise Data Protection gelten.
- Aber: Anthropic-Modelle in Copilot, Researcher, Copilot Studio, Power Platform und den Microsoft 365 Apps sind derzeit von der EU Data Boundary ausgenommen. Die Datenverarbeitung findet also außerhalb der EUDB statt.
- Für Kunden in der EU, der EFTA und dem Vereinigten Königreich sind Anthropic-Modelle deshalb standardmäßig deaktiviert. Ein Admin (AI Administrator oder Global Administrator) muss sie aktiv freischalten.
- Seit April 2026 gibt es eine eigene Einstellung, um Anthropic als Standardmodell für Copilot in Word, Excel und PowerPoint in EU/EFTA und UK zu aktivieren.
- Die frühere Option, Anthropic als unabhängigen Verarbeiter unter eigenen Vertragsbedingungen zu nutzen, wurde am 1. Mai 2026 abgeschaltet. Wer damals zugestimmt hatte, muss erneut aktiv freischalten.
4. Sonderfall: Modelle mit Datenspeicherung (Data Retention)
Besondere Vorsicht ist bei den sogenannten „Anthropic models with Data Retention“ geboten, etwa Claude Fable 5.1 oder Claude Mythos 5. Hier gilt:
- Die Daten werden von Anthropic gespeichert und fallen nicht unter die Microsoft Product Terms und das DPA. Stattdessen gelten Anthropics eigene Geschäftsbedingungen und Datenschutzvereinbarung.
- Anthropic speichert die meisten Ein- und Ausgaben bis zu 30 Tage. Bei möglichen Verstößen gegen die Nutzungsrichtlinien können Inhalte bis zu zwei Jahre aufbewahrt werden.
- Diese Modelle sind überall standardmäßig deaktiviert und müssen separat freigeschaltet werden. Im Produkt ist erkennbar, dass ein Modell Datenspeicherung erfordert.
- Fable 5.1 kann je nach Berechtigung Ihrer Organisation auch ohne Datenspeicherung unter Microsofts DPA verfügbar sein – das sollten Sie mit Ihrem Microsoft Account-Team klären.
5. Ein Detail, das oft übersehen wird: Flex Routing
Auch bei rein Microsoft-gehosteten Modellen können Copilot-Prompts, Antworten und Grounding-Daten zu Spitzenlastzeiten außerhalb der EU Data Boundary verarbeitet werden – zum Beispiel in den USA, Kanada oder Australien. Das betrifft Tenants, die sogenanntes Flex Routing zulassen. Prüfen Sie diese Einstellung, wenn eine strikte EU-Verarbeitung für Sie Pflicht ist.
So steuern Sie das im Admin Center
Alle Anbieter steuern Sie zentral im Microsoft 365 Admin Center: Copilot → Einstellungen → Alle anzeigen → AI providers operating as Microsoft subprocessors. Dort lässt sich pro Anbieter festlegen, ob alle Benutzer, bestimmte Benutzer bzw. Entra-ID-Sicherheitsgruppen oder niemand Zugriff erhält. Für Copilot Studio und die Power Platform gibt es zusätzlich Einstellungen im Power Platform Admin Center. Ist Anthropic deaktiviert, wählt der Auto-Modus einfach aus den übrigen Modellen.
Der zweite Regler: Reasoning-Effort und Credits
Neben dem Modell gibt es einen zweiten, oft unterschätzten Regler: den Reasoning-Effort. Er bestimmt, wie gründlich – und damit wie langsam und teuer – das Modell arbeitet.
| Stufe | Wofür |
|---|---|
| Light | Leichte Aufgaben, schnellste Antwort, wenigste Credits |
| Medium (Standard) | Starke Balance für den Alltag; der Standard kann je Modell variieren |
| High | Tiefere Analyse, komplexeres Reasoning |
| Extra High | Sehr gründliche, langsamere Antworten |
| Max | Für die härteste Arbeit – höchste Latenz und meiste Credits |
- Der Verbrauch hängt von Modell, Kontextvolumen, Orchestrierung und genutzten Tools ab.
- Der gewählte Effort gilt bis zur nächsten Änderung – höher heißt gründlicher, langsamer und teurer.
- Jede Antwort zeigt ein Modell-Badge; die Modellwahl gilt pro Gerät (Web, Windows und macOS).
Praxistest: Das günstigste Modell ist nicht immer das günstigste
Für den Vortrag habe ich drei Basismodelle – GPT 5.5, Claude Sonnet 5 und Claude Opus 4.8 – mit vier typischen Aufgaben getestet und Ergebnisqualität (Skala 0–10) sowie Credit-Verbrauch verglichen:
| Aufgabe | Qualität GPT 5.5 / Sonnet 5 / Opus 4.8 | Credits GPT 5.5 / Sonnet 5 / Opus 4.8 | Ergebnis je 100 Credits |
|---|---|---|---|
| Morgenbriefing | 1 / 5 / 8 | 608 / 111 / 163 | 0,16 / 4,50 / 4,91 |
| Kalender organisieren | 1 / 4 / 8 | 332 / 85 / 193 | 0,30 / 4,71 / 4,15 |
| LinkedIn-Recherche (Skill) | 4 / 8 / 8 | 122 / 69 / 104 | 3,28 / 11,59 / 7,69 |
| PowerPoint per Vorlage | 4 / 6 / 8 | 1.644 / 1.102 / 558 | 0,24 / 0,54 / 1,43 |
Das Ergebnis hat übrigens viele Zuhörer überrascht: GPT 5.5 hat in diesem Test bei allen vier Aufgaben die meisten Credits verbraucht und gleichzeitig die schwächsten Ergebnisse geliefert. Claude Sonnet 5 war bei Routineaufgaben wie dem Kalender oder der LinkedIn-Recherche am effizientesten, Claude Opus 4.8 lieferte durchgehend die beste Qualität und war bei der aufwendigen PowerPoint-Erstellung sogar am sparsamsten.
Die Lehre daraus ist also: Nicht der Preis pro Anfrage zählt, sondern das Ergebnis pro Credit. Ein Modell, das mehrere Anläufe braucht oder nachgebessert werden muss, wird schnell zum teuersten.
Meine Empfehlung für Unternehmen in Deutschland und der EU
- Daten klassifizieren: Legen Sie fest, welche Informationen die EU Data Boundary nicht verlassen dürfen. Nutzen Sie dafür Vertraulichkeitsbezeichnungen.
- Sensible Daten = Microsoft-gehostetes GPT: Für personenbezogene, vertrauliche oder regulierte Inhalte ist das von Microsoft betriebene GPT 5.5 die erste Wahl.
- Claude gezielt freischalten: Statt pauschal „an“ oder „aus“ lieber eine Pilotgruppe per Entra-ID-Sicherheitsgruppe berechtigen – nach Abstimmung mit Datenschutzbeauftragten und gegebenenfalls Betriebsrat.
- Modelle mit Data Retention meiden: Für produktive Unternehmensdaten nur nach sorgfältiger rechtlicher Prüfung freischalten.
- Effort bewusst wählen: Light oder Medium für den Alltag, High und mehr nur dort, wo Tiefe wirklich gebraucht wird.
- Messen statt raten: Testen Sie Ihre wichtigsten Anwendungsfälle mit verschiedenen Modellen und vergleichen Sie Ergebnis pro Credit.
- Einstellungen regelmäßig prüfen: Die Standardwerte ändern sich – wie die automatische Aktivierung der OpenAI-Subprozessor-Modelle im Juli 2026 gezeigt hat.
Fazit
Die Modellauswahl im Copilot ist ein echter Hebel – für Qualität, Kosten und Compliance. GPT punktet mit Geschwindigkeit und, in der von Microsoft betriebenen Variante, mit der klarsten Datenschutzposition für die EU. Claude überzeugt mit Gründlichkeit, Textqualität und in meinen Tests mit einer besseren Credit-Effizienz, wird aber außerhalb der EU Data Boundary verarbeitet. Wer beides bewusst kombiniert und die Admin-Einstellungen im Griff hat, holt aus Copilot deutlich mehr heraus.
Sie möchten wissen, welche Modelle in Ihrem Tenant aktiv sind oder wie Sie eine sichere Modellstrategie aufsetzen? Sprechen Sie mich gerne an.
Weiterführende Links
- Microsoft Learn: OpenAI als Subprozessor in Microsoft Online Services
- Microsoft Learn: Anthropic-Modelle in Microsoft Online Services
- Microsoft Learn: Ein Modell für Copilot Cowork auswählen
- Microsoft Learn: EU Data Boundary – laufende Teilübertragungen
- Hier im Blog: Zero Trust für KI-Agenten – warum Agenten ein neues Risiko sind
- Hier im Blog: Agenten mit Copilot Studio und Microsoft Foundry sicher bauen
Stand: Oktober 2026. Die Angaben zu Hosting und EU Data Boundary basieren auf der Microsoft-Learn-Dokumentation zu Anthropic und OpenAI als Subprozessoren. Microsoft passt Modelle und Einstellungen laufend an – prüfen Sie daher vor Entscheidungen die aktuellen Angaben.
